Unicode-Normalisierung
EmEditor unterstützt die Normalisierung von Unicode-Zeichen und -Sequenzen. Ein Beispiel, bei dem die Textnormalisierung nützlich ist, ist ein Datensatz mit Unicode-Eingaben aus vielen Quellen. Möglicherweise möchten Sie alle Zeichenfolgen in eine einzige Form normalisieren, damit das Abgleichen äquivalenter Zeichen einfacher wird.
UAX #15 Unicode Normalization Forms beschreibt vier Algorithmen zur Normalisierung von Zeichen und Sequenzen: kanonische Komposition, kanonische Dekomposition, Kompatibilitätskomposition und Kompatibilitätsdekomposition.
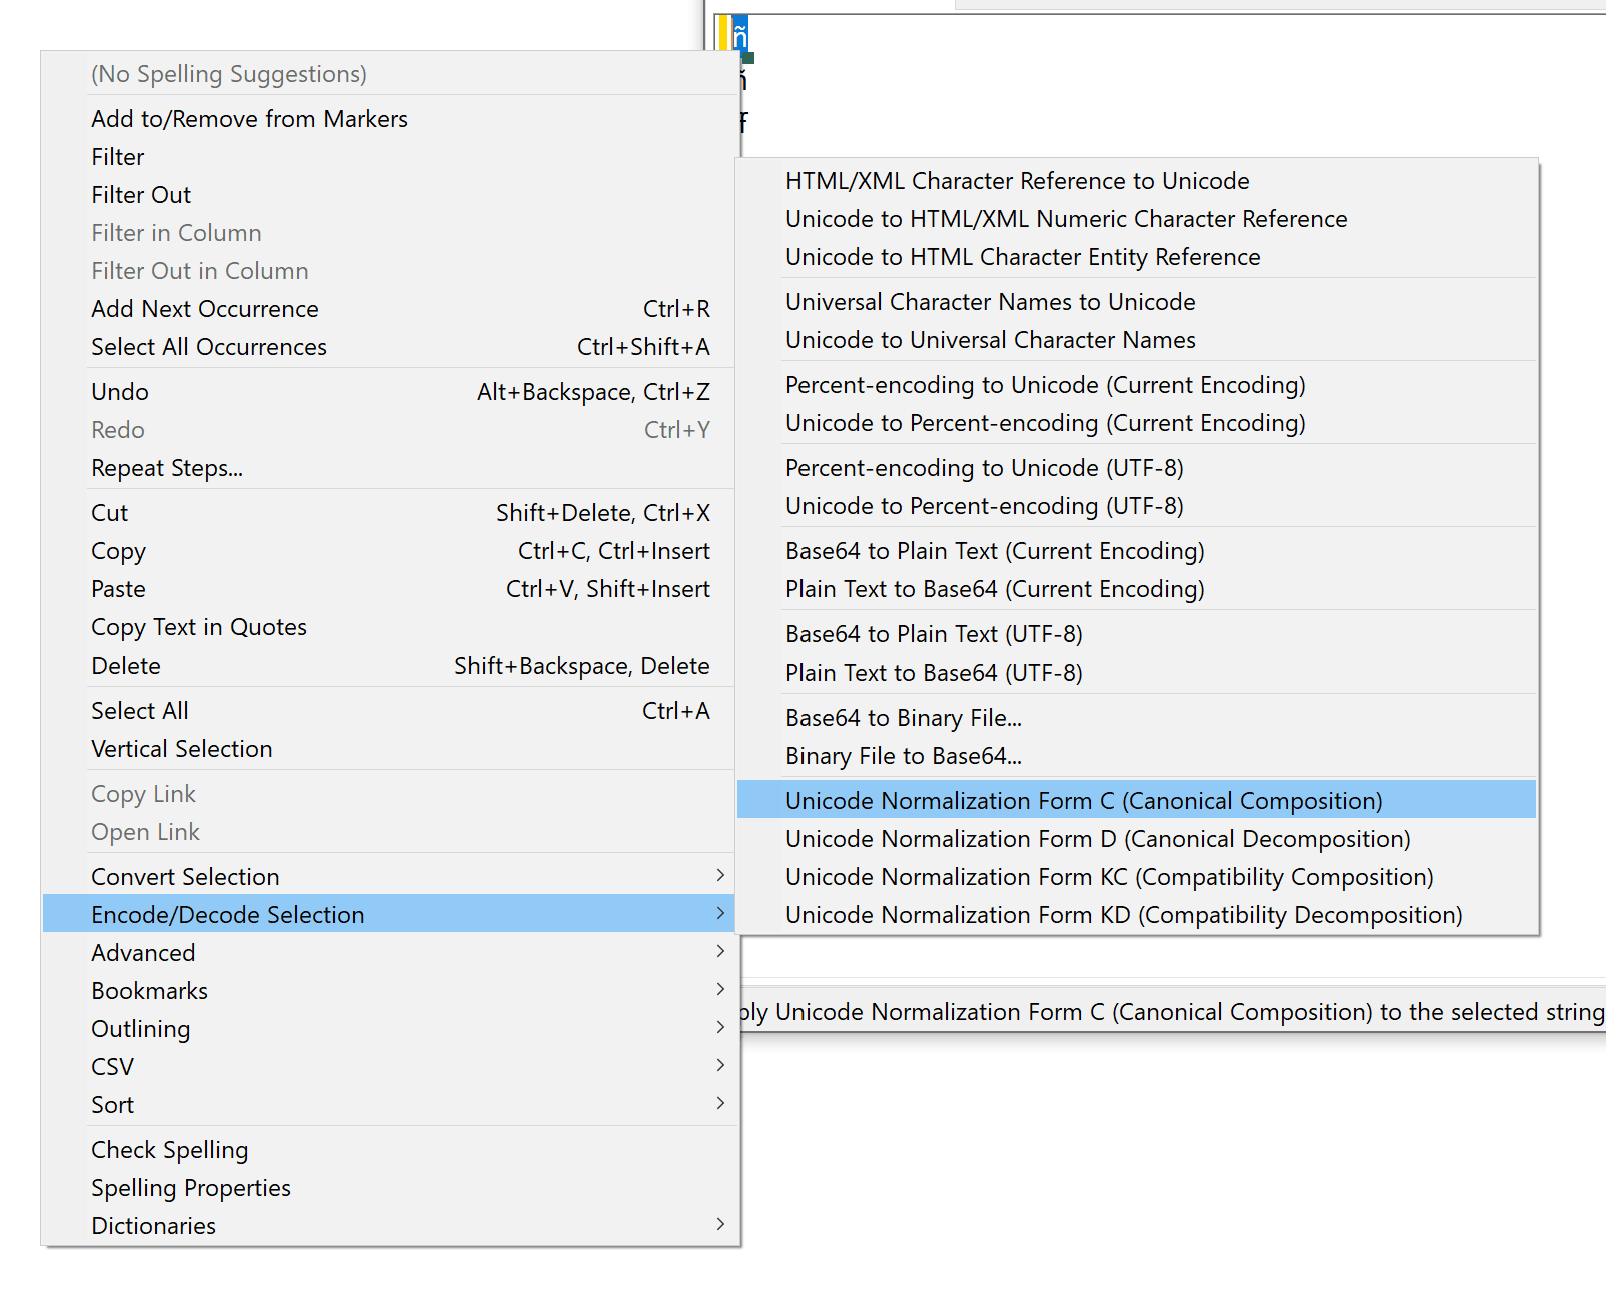
Dekomposition ist der Vorgang, bei dem ein Zeichen in seine kleineren Einheiten zerlegt wird. Wenn wir die kanonische Dekomposition auf das einzelne Zeichen ñ, ein LATIN SMALL LETTER N WITH TILDE, anwenden und den Zeichencodewert (STRG+I) anzeigen, zeigt sich, dass die Sequenz nun aus zwei Zeichen besteht: LATIN SMALL LETTER N; COMBINING TILDE. Die kanonische Komposition kehrt den vorherigen Befehl um.
Alle kanonischen Äquivalenzen sind kompatibel, aber nicht alle kompatiblen Beziehungen sind kanonisch äquivalent. Kanonisch äquivalente Formen sind in Aussehen und Bedeutung identisch, wie im vorherigen Beispiel mit ñ.
Andererseits können zwei kompatible Formen etwas unterschiedlich aussehen und haben nur in bestimmten Kontexten dieselbe Bedeutung. ¼ und 1/4 sind kompatible Formen, aber nicht kanonisch äquivalent. ¼ sieht etwas anders aus als 1/4. Während ¼ „ein Viertel“ bedeutet, bedeutet 1/4 manchmal „eins geteilt durch vier“, sodass sie nur in bestimmten Kontexten austauschbar sind.
Auf die Normalisierungsbefehle greifen Sie über Konvertieren > Kodieren/Decodieren zu.